技術筆記
AI、邊緣運算、系統整合的實作紀錄。
- 4 分鐘
搬家記:把部落格從一個沒人找得到的網域搬回來
舊站的每一篇文章,原始碼裡都沒有 title、沒有 description、沒有 canonical,公式還是純文字。這篇記錄我們把部落格搬回 jecision.com 的過程,以及三個差點讓上線失敗的意外。
nuxtseo重構
- 3 分鐘
Attention 其實是一個核平滑器
第一次看到「attention 是核方法」這個說法時,我以為那只是類比。自己推過一次才發現不是——而這件事直接決定了我們該在哪裡砍計算量。
transformer數學推論
- 6 分鐘
連續自迴歸語言模型 CALM 技術解析
傳統大模型逐字(Token-by-token)生成的效率已觸及物理天花板。CALM 將離散 Token 轉換為連續向量(Continuous Vectors),將生成步數縮減至原來的 1/K,為大語言模型的擴充開闢了全新的效率路徑。
paperllmefficiency
- 5 分鐘
大語言模型上下文壓縮技術:Headroom 底層邏輯與架構原理分析
專為 LLM 與 AI 代理設計的開源上下文壓縮層,透過三階段管線與可逆壓縮機制(CCR),在維持推論準確度的前提下縮減 60%-95% 的 Token 消耗
llmcontext架構
- 35 分鐘
TriAttention:程式碼與推理智能體之三角函數自適應上下文修剪機制與理論深度分析報告
隨著人工智慧在軟體工程與複雜邏輯運算領域的快速演進,大語言模型(Large Language Models, LLMs)的應用範疇已經從早期的單純文本補全(Code Completion),跨越至具備自主決策與長鏈條推理能力的代理系統(Autonomous Agents)
paperagentattention
- 34 分鐘
SWE-Pruner:程式碼智能體之自適應上下文修剪機制與理論深度分析報告
在當代軟體工程的演進歷程中,大型語言模型(Large Language Models, LLMs)的應用已經跨越了單純的程式碼片段補全與靜態語義分析,正式邁入能夠自主導航龐大程式碼庫
paperagentcontext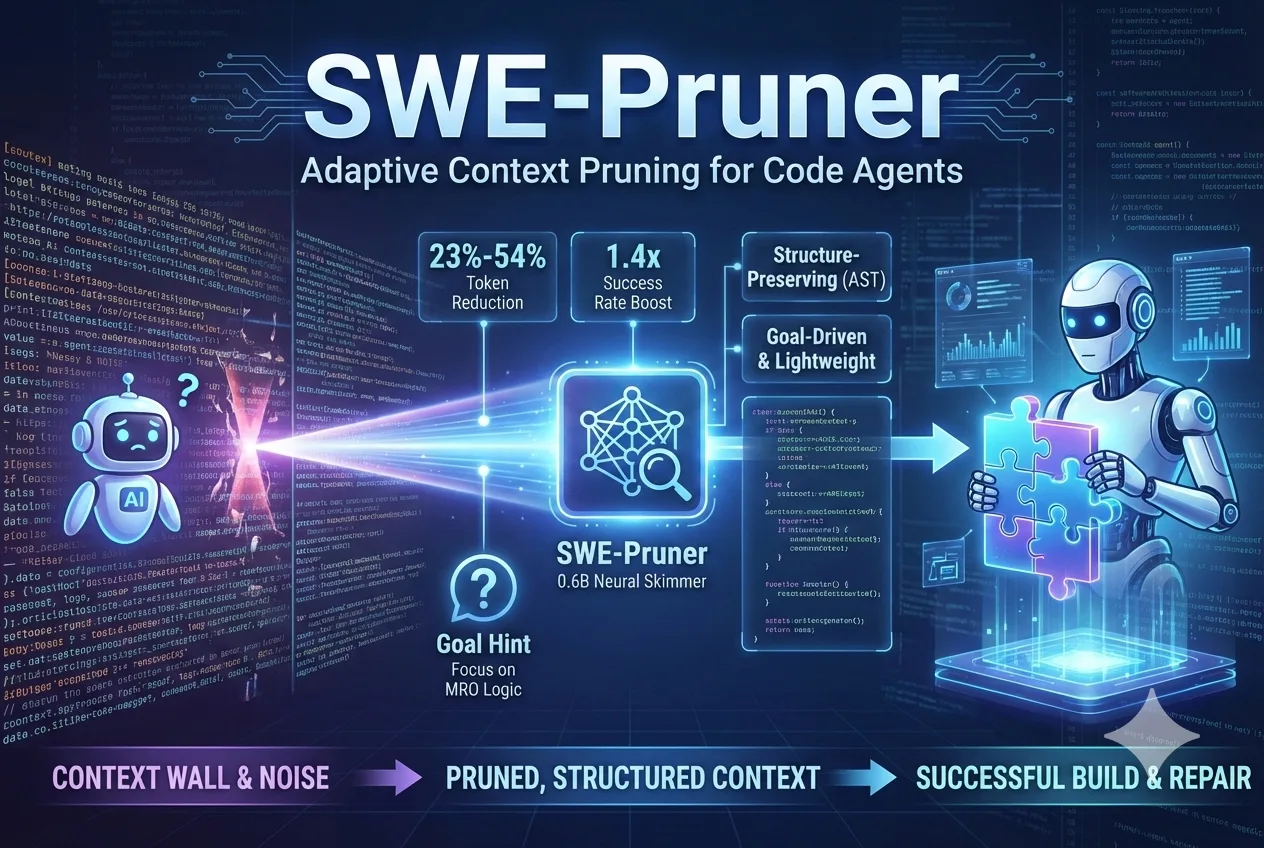
- 23 分鐘
Transformer 注意力機制的貝葉斯幾何學:機制與理論深度分析報告
Naman Agarwal等人2026年開創性研究證實Transformer透過注意力機制精確實現貝葉斯推理,揭示其上下文學習的幾何本質並為提示工程奠定理論基礎。
papertransformerbayesian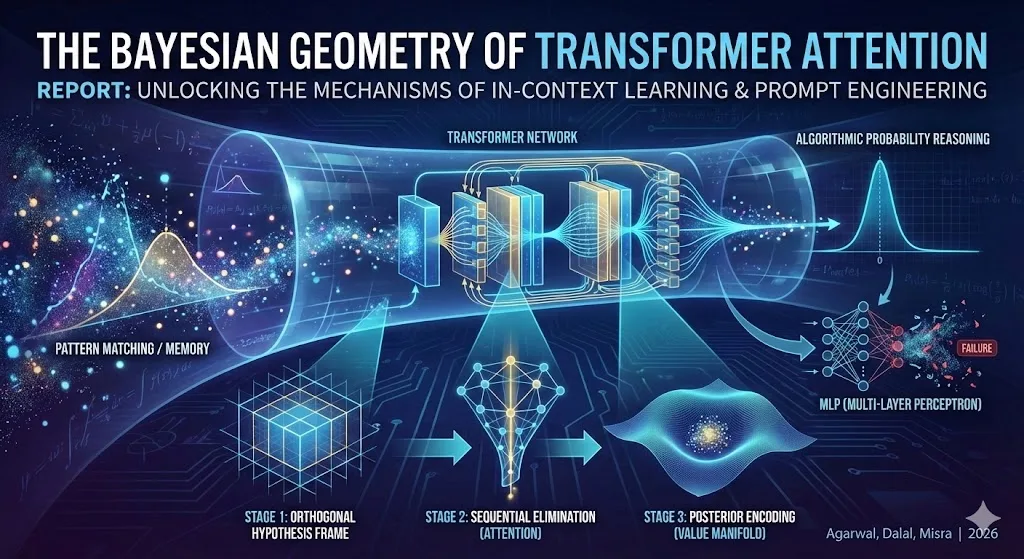
- 16 分鐘
嵌套學習:深度學習架構的幻象
提出了 嵌套學習 這一新的學習典範,將機器學習模型表示為一組嵌套的、多層次的優化問題,每一層都有自己的「上下文流」。從 NL 的角度看,現有深度學習方法通過壓縮自身的上下文流來從數據中學習,而大型模型中的上下文學習自然湧現。NL 提出了一種哲學思想,即設計具有更多「層次」、更富表達力的學習演算法,從而實現更高階的上下文學習,並可能解鎖有效的持續學習能力。
papernested-learningmemory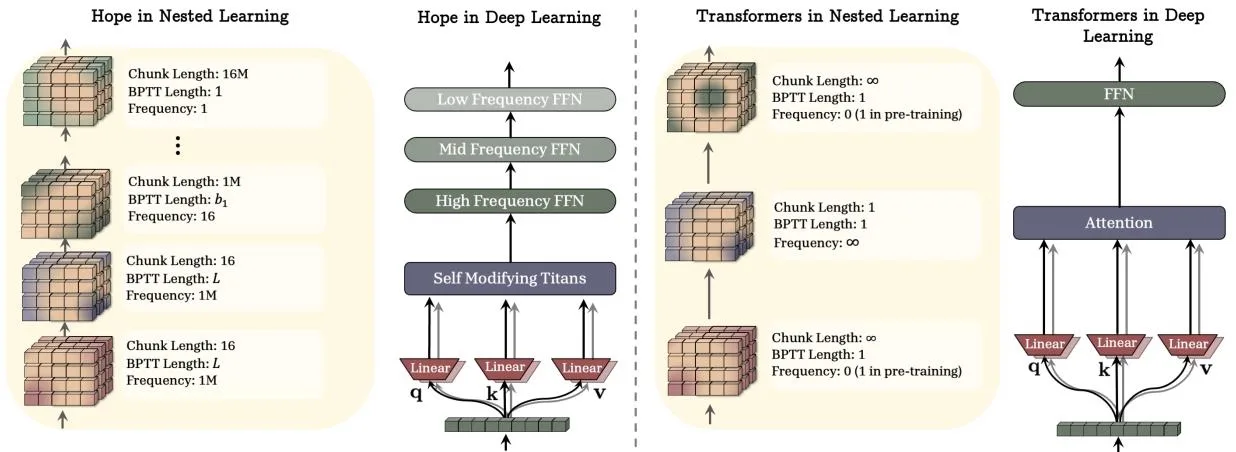
- 5 分鐘
Offset Geometric Contact 論文彙整
關於《Offset Geometric Contact》論文的詳細條列式彙整,涵蓋方法、演算法和實驗結果。
paperphysicscollision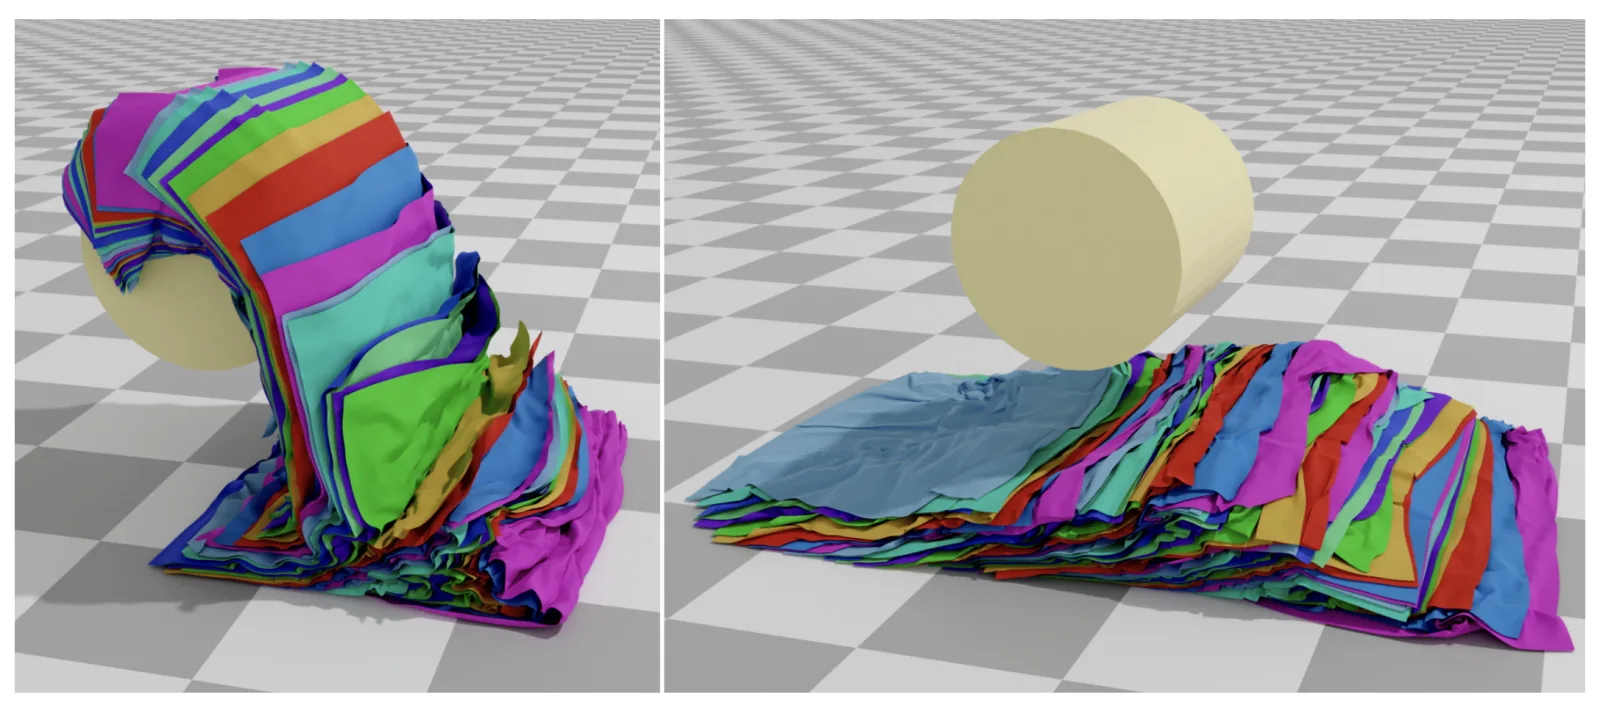
- 6 分鐘
複雜城市系統的實體資訊AI綜述
城市系統的物理資訊 AI 綜述:整理這篇 survey 如何把物理約束接進都市尺度的預測模型,以及它點出的資料、尺度與可解釋性缺口。
paperurbansurvey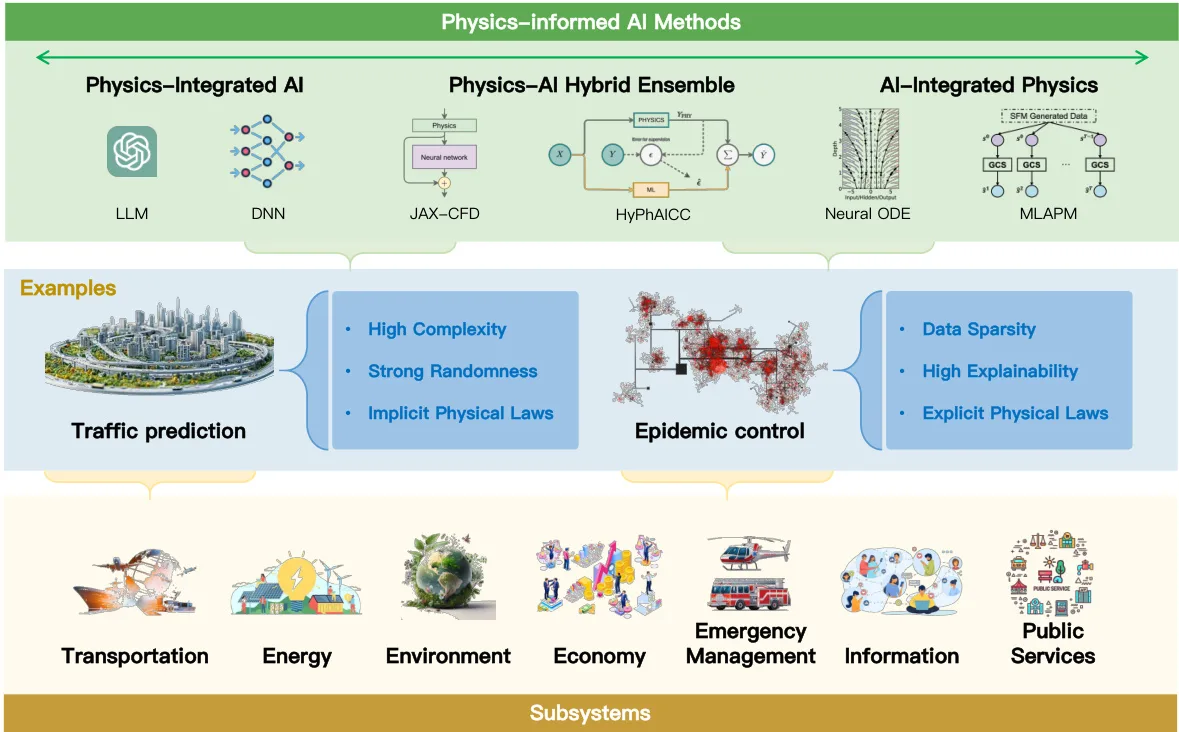
- 3 分鐘
基於稀缺資料的物理資訊學習:從資料中發現控制方程式
PiDL 用稀疏又帶噪音的觀測資料反推非線性時空系統的偏微分方程;本文整理它的網路架構、訓練策略,以及在 Burgers 與 Navier–Stokes 上的實測表現。
paperphysics-informedpde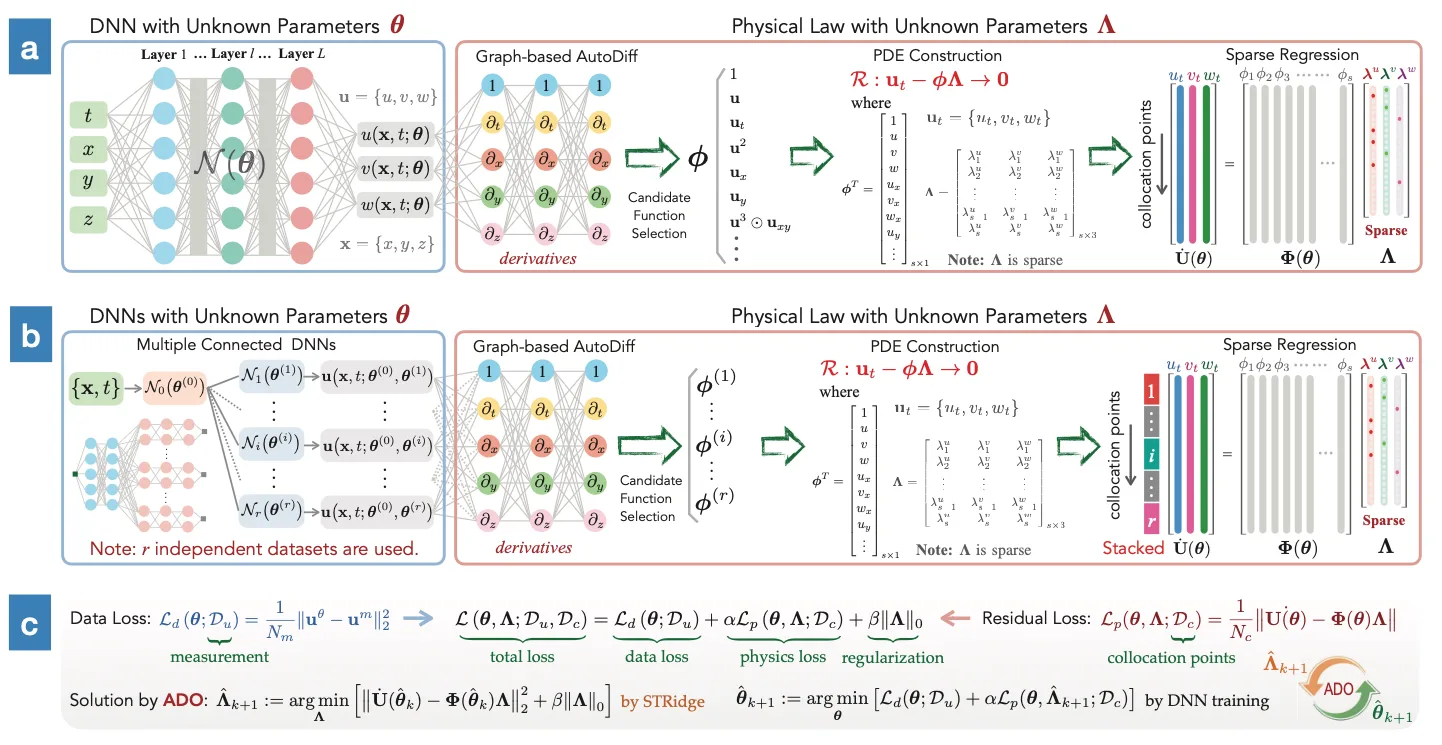
- 3 分鐘
Gemini for Workspace 提示指南精要
把 Google Workspace 裡 Gemini 的提示技巧整理成可直接照抄的模板:角色設定、上下文邊界、輸出格式,以及最常見的四種失敗模式。
geminiprompt